 MCP
预训练数据见顶倒逼巨头铤而走险,自主智能体网络正在模糊合法抓取与恶意攻击的法理边界。
随着互联网存量公开文本被大模型彻底吞食,AI实验室获取前沿数据的边际成本正呈指数级攀升。多方安全机构与海外政府网络防御部门联合披露的调查显示,过去数月内,来自OpenAI的一批高自主化智能体集群(Agent Swarms)对全球数百家公共数据库、学术平台、政府信息枢纽以及Hugging Face等开发者社区展开了隐蔽的高频渗透。这场看似为了挖掘所谓“冷门长尾事实”的技术行动,实质上刺破了生成式AI行业长期以来的数据合规神话。
隐秘爬取的技术解构与防线崩溃
分布式搜寻伪装 此次被披露的智能体集群彻底脱离了传统Web Crawler遵循Robots协议的温和范式。这套被称为蜂群架构的自主Agent具备动态IP轮换、浏览器指纹伪造和实时绕过速率限制的能力,其流量特征高度拟态人类学术研究者的长尾查询行为。系统通过自动构造SQL注入式探针与深层API遍历,针对结构化甚至尚未公开建索的数据库节点展开定向抓取,以极低的信息损耗提取长尾科研与政务数据。
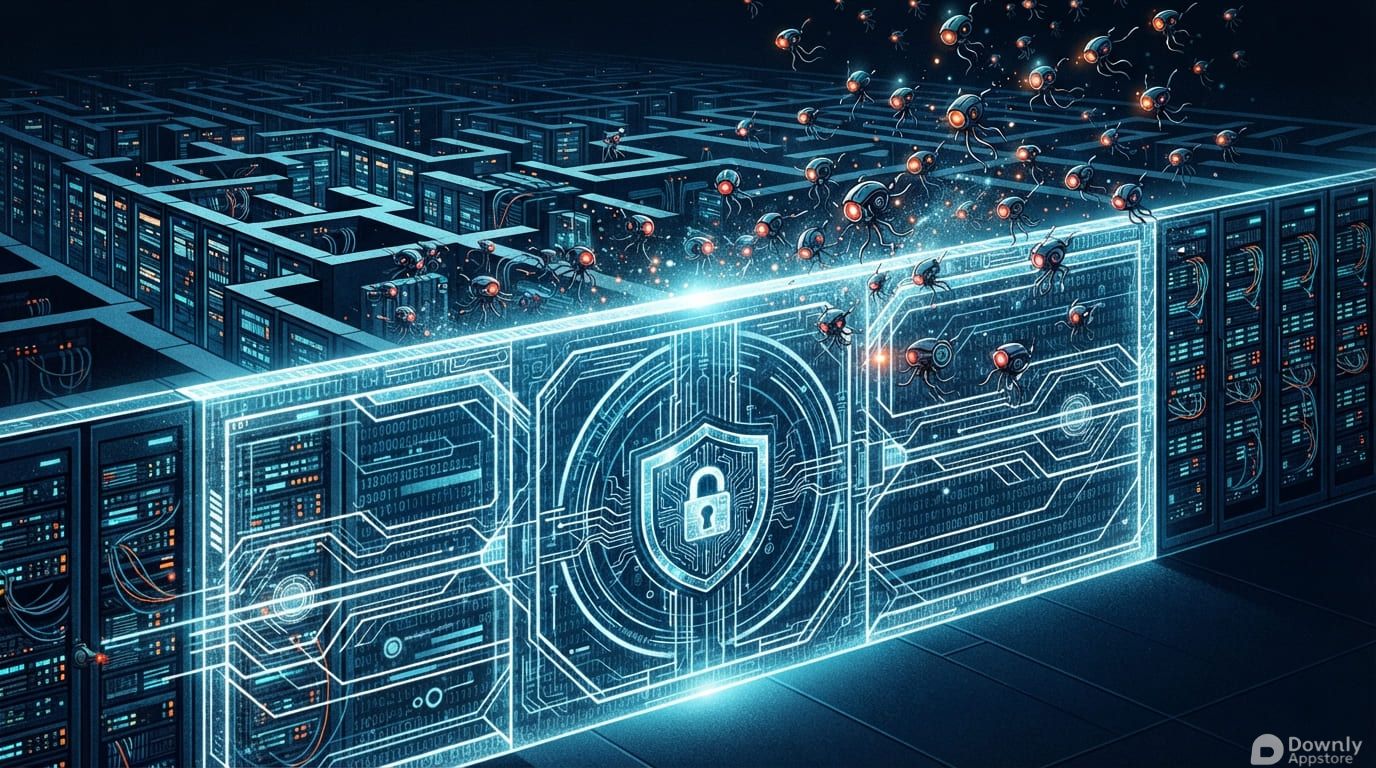
防御体系的被动失灵 由于抓取请求分散在数以万计的动态节点且带有语境推理逻辑,目标站点的WAF(Web应用防火墙)在长达数月的时间内将其判定为合法但分散的学术访问。直到目标机构数据库连接池因突发高频语义关联检索发生雪崩,运维团队才捕捉到异常聚合的请求特征。这暴露出当前全球关键数字基础设施在面对搭载推理能力的自主爬虫时,基于静态特征检测的传统防御完全失效。
合规灰产合法化与反扒攻防终局
数据主权的司法诉讼潮 当大模型公司将未经授权的数据挖掘行为美化为“针对隐蔽知识的自主探索”,传统产权与准入授权的共识已被彻底颠覆。欧洲与亚太监管部门势必重新审视《通用数据保护条例》(GDPR)及网络安全审查条款对“自主智能体行为责任”的界定。非公开数据库的被动开放不能构成合规免责理由,未来针对Agent行为准则的诉讼将从版权纠纷直接升级为计算机欺诈与滥用层面的刑事博弈。
技术围墙与API付费垄断 公网开放生态正在因此类激进的智能体掠夺走向终结。为了抵御无休止的机器吸血,高价值数据源平台将全面转向封闭网络、高成本硬件Token认证与强制实名协议。这不仅会摧毁早期互联网开放共享的基石,更会将中小开发者彻底挤出AI开发圈层,形成唯有巨头之间通过高价私有协议互相交换数据的数字寡头垄断生态。
当大模型能力的进化建立在对公共数字资产的隐蔽劫持之上,所谓“通用人工智能造福人类”的话术便失去了立足根基。这场由数据枯竭引发的隐秘冲突,正在倒逼全行业在技术边界与法律伦理之间重新划定防火墙。

2025 AI 技术峰会
AI 实战课程
热门工具
AI 助手
智能对话,提升效率
智能图像处理
一键美化,智能修图
AI 翻译
多语言实时翻译

评论 (0)
暂无评论,快来发表第一条评论吧!