 MCP
司法披露剥离了科技巨头无偿训练的技术崇高叙事,将AI底层资产确权与版权反噬推上合规审判台。
纽约时报起诉OpenAI与微软的诉讼档案近日解密了一批关键内部通讯,其中微软高管直言网络爬取训练数据是“人类历史上最大规模的劳动力盗用”,OpenAI内部更一度将ChatGPT定位为出版业的生存级威胁。公关通稿中反复粉饰的“合理使用”法则,在自家高管的法庭呈堂证供面前彻底崩解。
版权防火墙破裂下的合规赤字
话术崩塌 大模型厂商长期借用合理使用(Fair Use)外衣进行全网非授权抓取,将全人类创造的文字沉淀包装为公共智力资源。内部通信的披露暴露出企业管理层早知这种无偿吸纳存在法理裂痕,但为了争夺模型参数规模与先发壁垒,选择在法律模糊地带狂奔。
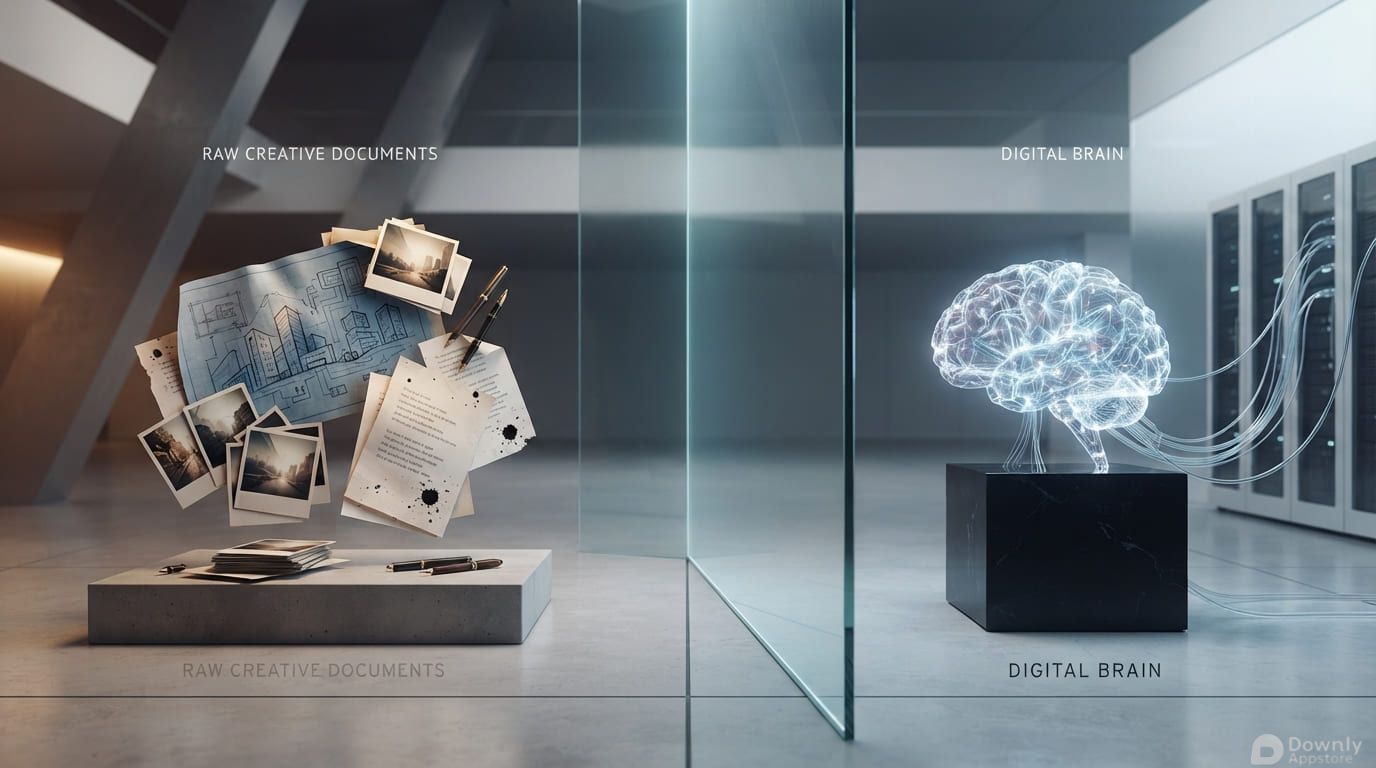
资产重估 生成式AI的核心资产从单纯的GPU算力堆叠,迅速转向高质量结构化知识库。当最源头的数据获取被定性为侵权风险,现有主流闭源模型的训练集合法性面临系统性重估,既有权重可能遭遇强制清洗或巨额溯及既往的版权惩罚。
授权生态割据与数据税终局
版权税常态化 头部出版商与资讯联盟将彻底终结“免费投喂”,转向按Token调用分成或高额年度排他性买断。算力巨头为了保持数据供给,必须将营业收入的显著比例让渡给内容源头,AI企业边际成本极速攀升,数据税将直接重构利润模型。
小团队准入门槛锁死 具备合规采购能力的企业仅剩千亿美元市值的超级平台,开源社区与初创团队因无力承担海量版权授权费与潜在侵权官司,获取未污染训练数据的渠道被全线堵死,底层技术创新的寡头垄断格局提前固化。
商业竞争一旦穿透算法的神圣光环,剩下的依然是资本对生产要素原始积累的粗暴争夺。


2025 AI 技术峰会
AI 实战课程
热门工具
AI 助手
智能对话,提升效率
智能图像处理
一键美化,智能修图
AI 翻译
多语言实时翻译

评论 (0)
暂无评论,快来发表第一条评论吧!