 MCP
DeepSeek-V4.1-Flash 杀入 Agent Arena 榜单前三 极限推理架构颠覆前沿闭源壁垒
极致工程优化压榨单位算力效能,开源稀疏架构逼平顶尖闭源旗舰,模型部署经济学正在被彻底改写。
在衡量复杂工具调用与长程环境交互能力的 Agent Arena 评测基准中,全新开源模型 DeepSeek-V4.1-Flash(Max)拿下综合排名开源赛道第三、全榜第四的战绩,多项复杂工程指标逼平闭源旗舰 GPT-6 Astra。在长文本上下文理解、多步自主容错机制与分布式 API 调度评测中,该模型凭借极高的推理吞吐率和轻量化的显存占用,打破了超大参数与闭源架构对高阶智能体工作流的长期垄断。
稀疏架构极限压榨 显存带宽与长程推理的工程突破
细粒度路由与稀疏激活 DeepSeek-V4.1-Flash 能够以极低显存代价抗衡闭源巨兽,关键在于其对专家混合(MoE)架构的重构。不同于传统大粒度专家切分方案,该模型采用了更激进的细粒度专家路由算法,大幅增加了候选专家数量,每次前向传播仅激活极少比例的计算单元。配合多头潜在注意力机制(MLA)对键值缓存(KV Cache)的深度压缩,系统在处理长达 128k 的连续智能体交互上下文时,显存带宽占用相较传统注意力机制缩减了近 70%,从根本上攻克了智能体多轮轮询引发的显存墙瓶颈。
执行反馈强化的反思机制 在训练方法论上,该模型摒弃了依赖人工合成数据的模仿学习路径,大规模引入基于工具执行反馈的强化学习(RL with Tool Execution Feedback)。当智能体在虚拟环境中遭遇代码编译失败、接口报错或数据格式不匹配时,模型内部集成的反思损失函数被强制激活,迫使网络学会自主倒推错误栈并生成替代路径。这一架构层面的改进,直接消除了智能体在面对未知异常时陷入循环死锁的顽疾。
算力性价比洗牌催生端云协同裂变
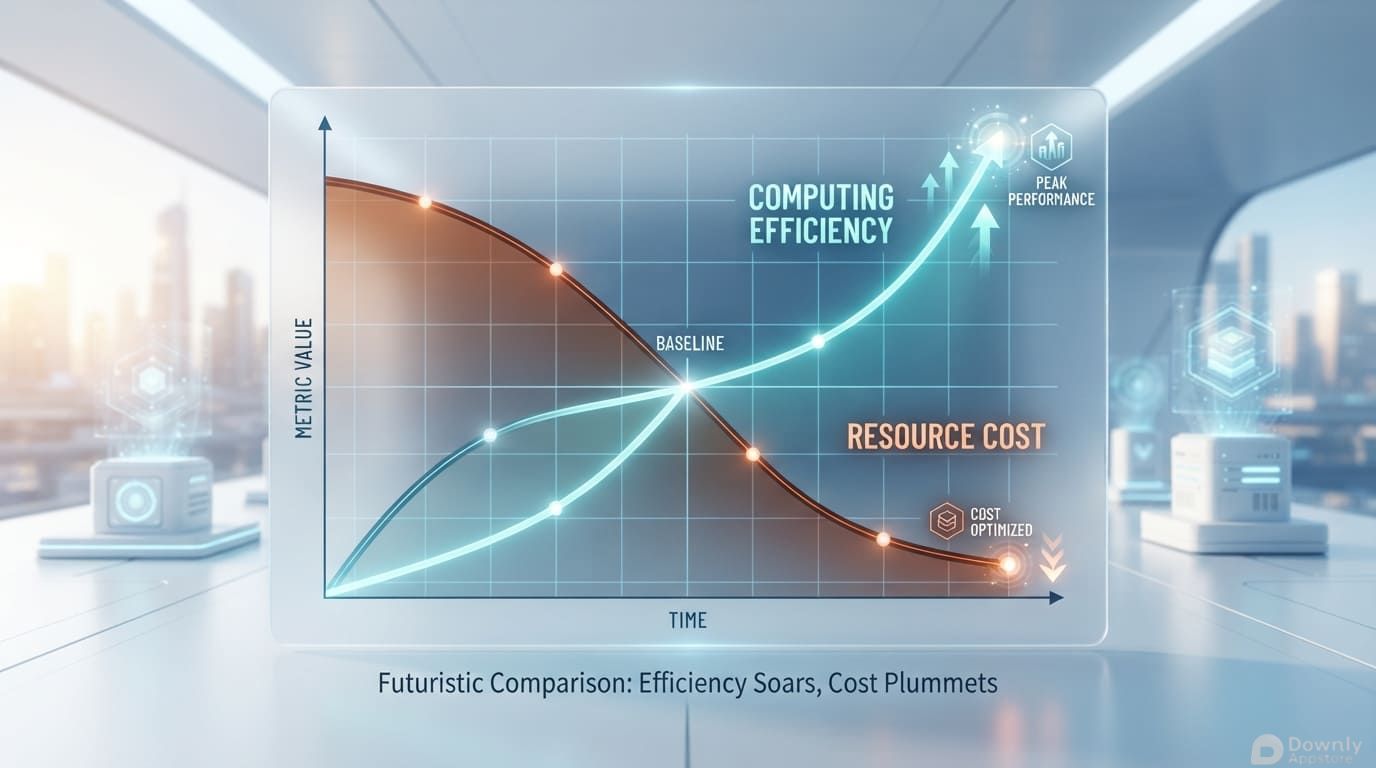
商业 API 暴利窗口坍塌 高昂的 Token 计费曾是企业将智能体全面落地的最大阻碍。DeepSeek-V4.1-Flash 在消费级工作站甚至单张高端加速卡上的高效部署能力,将单次复杂长程任务的推理成本压缩至闭源 API 的十分之一甚至更低。这直接瓦解了云端闭源厂商高定价策略的市场根基,迫使全行业将模型优化重心从虚荣的参数规模堆叠转向以每美元吞吐量(Tokens per Dollar)为指标的硬核工程战。
企业私有化智能体集群下沉 数据主权与推理成本的双重解耦,引爆了企业私有化智能体的大规模落地浪潮。金融风控、医疗合规审查以及核心工业控制代码的生成不再必须仰仗跨国云服务商的闭源接口。具备完全自主可控能力的轻量高效模型使得企业利用现有边缘基础设施搭建专属智能体调度中心成为现实,智能权力的多极化分布格局已不可逆转。
参数规模不再是衡量模型先进性的唯一维度。DeepSeek-V4.1-Flash 用无可辩驳的工程实践向产业证明:对算力底层效能的极致挖掘与算法创新,足以刺穿一切依靠蛮力资源构筑的商业闭源壁垒。

2025 AI 技术峰会
AI 实战课程
热门工具
AI 助手
智能对话,提升效率
智能图像处理
一键美化,智能修图
AI 翻译
多语言实时翻译

评论 (0)
暂无评论,快来发表第一条评论吧!