 MCP
Google DeepMind 发布 Gemini 3.8 实时多模态与深度思维双轨并行
突破实时流式音视频与长链深度推理的物理时延割裂,Google 首次在单套底座内打通快思考与慢思考协同架构。
Google DeepMind 正式对外发布 Gemini 3.8 Live 以及配备长链推理特性的 Gemini 3.8 Live Extended Thinking。不同于以往通过外挂语音识别与合成拼凑的伪实时方案,新版本实现了全模态原生流式摄入与双核推理引擎的动态无缝调度。这一举措标志着基础大模型正式跨越单次应答交互,向低延迟、高算力密度交织的持续主动交互形态演进。
跨模态原生流处理与双引擎协同逻辑
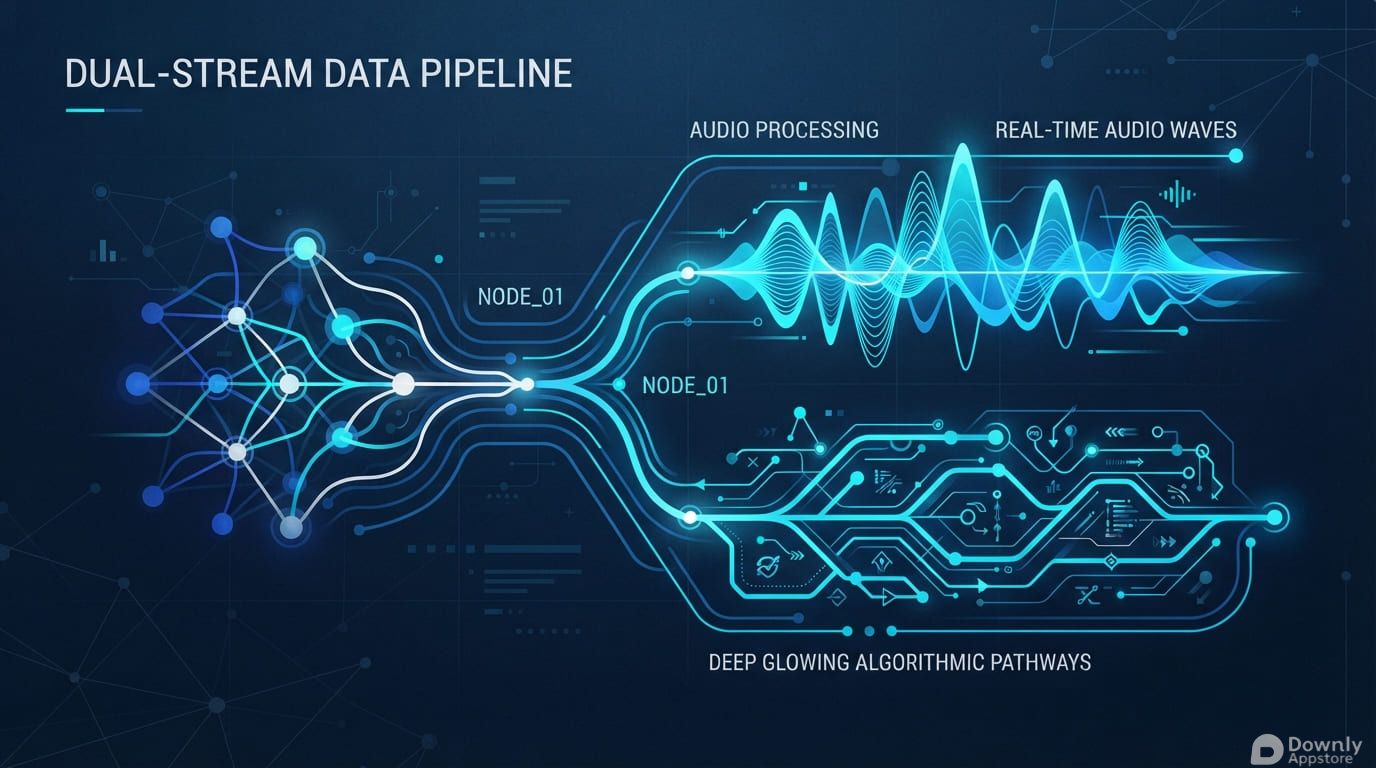
时延消除架构 传统多模态交互依赖级联管道,语音信号先经 ASR 转换为文本,大语言模型处理后再经 TTS 输出音频,整个回路延迟通常突破两秒,对话节奏极易破碎。Gemini 3.8 Live 采用端到端原生音视频 Token 流,音频频谱和视觉帧特征直接映射到底层隐空间,省去了跨模态数据格式转换的序列化损耗。模型对外部输入的感知被切分为亚秒级的滑动窗口,在保障首字音频生成时间压降至毫秒级的同时,完整保留了语调、断句与背景环境音的语义特征。
双态推理分支 Live Extended Thinking 的技术突破在于化解了快速响应与复杂慢思考之间的天然冲突。工程团队设计了自适应计算预算路由器,常规交流由轻量级低时延分支接管,一旦探测到需要多步归纳或形式化验证的意图,流式引擎在持续输出自然过渡语气维持连接的同时,后台并行唤醒扩展思考上下文。显存内部开辟出专属的思考草稿区,模型通过隐式思维链展开局部推导与反思验证,最终将浓缩提炼的严密结论以流式音频无缝交接给用户。
推理延迟压降诱发底层协议重塑
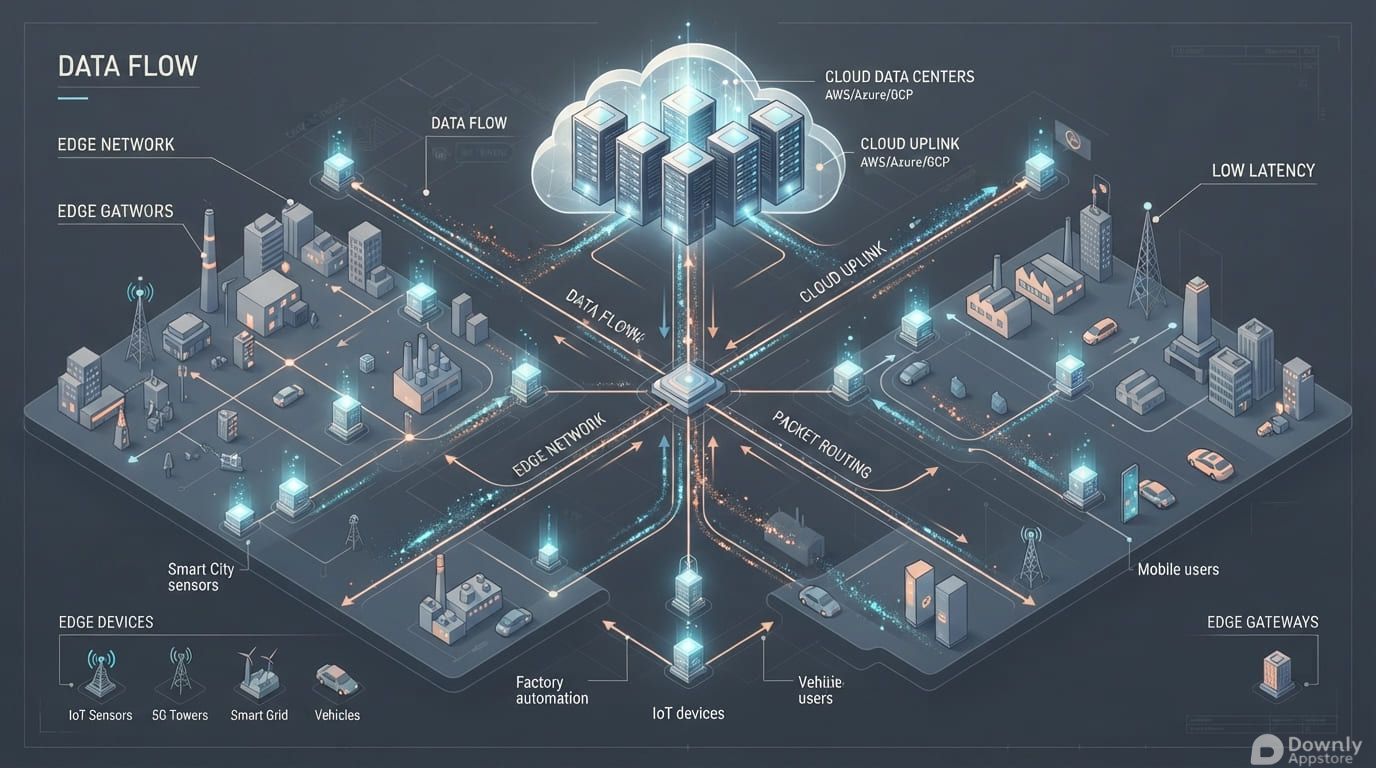
边缘分发标准统一 随着流式多模态推理全面进入亚秒级响应时代,现存基于 HTTP 轮询或单向 WebSocket 的应用层协议面临实质性淘汰。服务提供商必须转向集成 WebRTC 与 QUIC 协议的高并发低损耗网络拓扑,这意味着边缘计算节点不再仅仅承担静态缓存任务,必须直接下沉模型分片与 KV Cache 增量交换能力。算力网络从集中式机房单点计算,扩散至全球接入点网状协同,网络协议栈面临全维度的推倒重建。
端侧混合推理范式确立 极度密集的实时交互无法完全承受云端集群往返的传输抖动与高昂带宽开销。Gemini 3.8 的双轨架构倒逼芯片厂商加速端侧 NPU 与云端集群的协同分工。终端负责运行超低延迟的前置注意力感知层与即时语音流渲染,复杂逻辑运算与密集检索则依托稀疏化调度交由云端超算集群处理。端云混合执行管线正在成为下一代智能终端软件架构的基准规范。
从单向文本生成跃迁至原生流式多模态并行推理,Google DeepMind 正在把交互门槛从离散的人工输入压缩为环境级的连续感知。这一工程突破彻底重构了底层模型的服务接口形态,同时让真实物理世界对数字系统的实时召唤变为现实。
2025 AI 技术峰会
AI 实战课程
热门工具
AI 助手
智能对话,提升效率
智能图像处理
一键美化,智能修图
AI 翻译
多语言实时翻译

评论 (0)
暂无评论,快来发表第一条评论吧!